Pseudonymisering: hvad det er, hvad GDPR kræver, og hvordan I gør det rigtigt
Pseudonymisering erstatter navne og id-numre med pseudonymer, mens nøglen opbevares adskilt. Få definitionen i GDPR art. 4, nr. 5, forskellen til anonymisering, EDPB's retningslinjer, EU-Domstolens SRB-dom og en trin-for-trin-guide med regneeksempel.

Pseudonymisering er den sikkerhedsforanstaltning, GDPR nævner oftest, og samtidig den, der bliver misforstået mest. Nogle tror, at et datasæt uden navne er anonymt. Andre tror, at pseudonymiserede oplysninger altid og for alle er personoplysninger. Begge dele er forkert, og siden september 2025 har EU-Domstolen, Datatilsynet og Det Europæiske Databeskyttelsesråd (EDPB) alle udtalt sig om, hvor grænsen går.
Denne artikel er skrevet til compliance-ansvarlige, databeskyttelsesrådgivere (DPO'er) og it-chefer, der skal beslutte, hvornår pseudonymisering er det rigtige værktøj, hvilken teknik der holder, og hvad der stadig gælder, når pseudonymerne er på plads. Vi gennemgår definitionen i databeskyttelsesforordningen, EDPB's retningslinjer 01/2025, dommen i sag C-413/23 P og Datatilsynets to præciseringer fra efteråret 2025. Til sidst får I en proces i seks trin og et gennemregnet, fiktivt eksempel.
Det korte svar: hvad er pseudonymisering?
Pseudonymisering er behandling af personoplysninger på en måde, så de ikke længere kan henføres til en bestemt person uden brug af supplerende oplysninger, forudsat at de supplerende oplysninger opbevares separat og er beskyttet af tekniske og organisatoriske foranstaltninger. Det er ordlyden i GDPR art. 4, nr. 5, forkortet en smule.
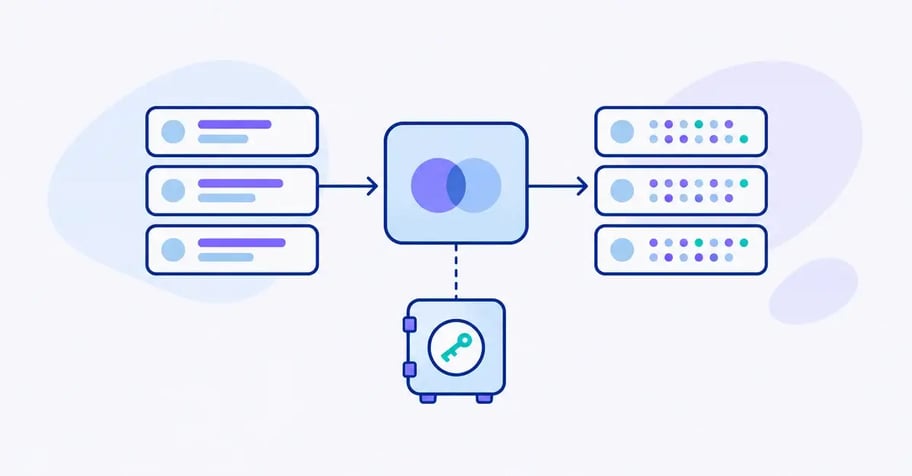
I praksis betyder det: I erstatter direkte identifikatorer som navn, CPR-nummer, e-mail eller kundenummer med et pseudonym, og I gemmer nøglen eller opslagstabellen, der kan føre pseudonymet tilbage til personen, et andet sted med skarp adgangsstyring. Data bevarer deres værdi til analyse, test og forskning, men den, der arbejder med dem, kan ikke se, hvem de handler om.
Tre konsekvenser følger med. Pseudonymiserede oplysninger er som udgangspunkt stadig personoplysninger for den, der har nøglen, så GDPR gælder fortsat. Pseudonymisering er ikke anonymisering, og de to må ikke forveksles i jeres dokumentation. Og pseudonymisering er en foranstaltning, ikke et behandlingsgrundlag, så I skal stadig have hjemmel i art. 6 til den behandling, pseudonymerne indgår i.
Tre begreber, der ofte bliver blandet sammen
Søgninger på pseudonymisering blander tit tre ting, som hører til forskellige kategorier. Før vi går i dybden, rydder vi op i dem.
| Begreb | Hvad det er | Er resultatet personoplysninger? | Retskilde |
|---|---|---|---|
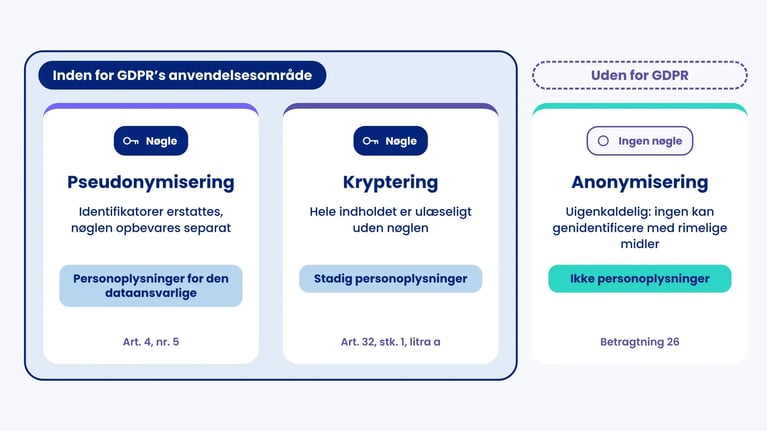
| Pseudonymisering | Identifikatorer erstattes med pseudonymer, nøglen opbevares separat. Kan vendes om af den, der har nøglen. | Ja for den dataansvarlige. For andre modtagere afhænger det af, om de med rimelige midler kan genidentificere. | Art. 4, nr. 5, betragtning 26, 28 og 29 |
| Anonymisering | Oplysningerne ændres, så ingen med rimelige midler kan identificere personen igen. Processen er uigenkaldelig. | Nej. Anonyme oplysninger falder uden for GDPR. | Betragtning 26, EDPB's udkast til retningslinjer 02/2026 |
| Kryptering | Hele indholdet gøres ulæseligt med en nøgle. Kan bruges som pseudonymiseringsteknik, men beskytter typisk data i transit og hvile. | Ja. Krypterede personoplysninger er stadig personoplysninger. | Art. 32, stk. 1, litra a, art. 34, stk. 3, litra a |
Den vigtigste pointe fra tabellen er, at anonymisering fjerner oplysningerne fra GDPR's anvendelsesområde, mens pseudonymisering holder dem inde i det. Det er også derfor, forordningen kan anbefale pseudonymisering som en sikkerhedsforanstaltning: den forudsætter, at reglerne stadig gælder. Læs mere om grænsen i vores artikel om anonymisering af personoplysninger.
Hvor i GDPR står pseudonymisering?
Pseudonymisering optræder en række steder i forordningens artikler og betragtninger, og hvert sted har sin egen funktion. Det er værd at kende dem, fordi de forklarer, hvad I reelt kan bruge foranstaltningen til, og hvad den ikke fritager jer fra.
| Bestemmelse | Hvad den siger om pseudonymisering | Hvad det betyder for jer |
|---|---|---|
| Art. 4, nr. 5 | Definitionen. Kræver separat opbevaring af supplerende oplysninger og tekniske og organisatoriske foranstaltninger. | Uden separat nøgleopbevaring og adgangsstyring er det ikke pseudonymisering i forordningens forstand. |
| Betragtning 26 | Pseudonymiserede oplysninger, der kan henføres til en person med supplerende oplysninger, er oplysninger om en identificerbar person. Alle rimelige midler skal medregnes. | Grundlaget for både EDPB's og EU-Domstolens vurdering. Testen er rimelige midler, ikke teoretisk mulighed. |
| Betragtning 28 og 29 | Pseudonymisering kan reducere risici og hjælpe med at overholde forpligtelser. Den kan foregå hos samme dataansvarlige, hvis nøglen holdes adskilt. | I må godt pseudonymisere internt, men analytikerne og nøgleholderne skal være adskilt organisatorisk og teknisk. |
| Art. 6, stk. 4, litra e | Passende garantier, herunder kryptering eller pseudonymisering, indgår i vurderingen af, om et nyt formål er foreneligt med det oprindelige. | Pseudonymisering kan gøre det lettere at genbruge data til analyse eller statistik uden nyt behandlingsgrundlag. |
| Art. 25, stk. 1 | Nævnes som eksempel på en foranstaltning til databeskyttelse gennem design. | Skal overvejes, når I designer eller indkøber systemer. Se vores artikel om databeskyttelse gennem design og standardindstillinger. |
| Art. 32, stk. 1, litra a | Nævnes sammen med kryptering som eksempel på en passende sikkerhedsforanstaltning. | GDPR kræver ikke pseudonymisering, men passende foranstaltninger ud fra risikoen. Fravalg skal kunne begrundes. |
| Art. 34, stk. 3, litra a | Underretning af de registrerede kan undlades, hvis oplysningerne er gjort uforståelige for uvedkommende. | Effektiv pseudonymisering kan efter en konkret vurdering begrænse underretningspligten. Anmeldelsen til Datatilsynet efter art. 33 påvirkes ikke automatisk. |
| Art. 89, stk. 1 | Nævnes som garanti ved behandling til forskning, statistik og arkivformål. | Central for forskningsinstitutioner, sundhedsvæsen og analyseafdelinger. |
| Art. 11 | Kan den dataansvarlige ikke identificere den registrerede, gælder art. 15 til 20 ikke, medmindre den registrerede selv leverer supplerende oplysninger. | Relevant for modtagere uden nøgle. Gælder ikke for den, der selv kan slå pseudonymet op. |
Bemærk, hvad der ikke står på listen. Pseudonymisering fritager ikke fra fortegnelsen over behandlingsaktiviteter i art. 30, fra oplysningspligten i art. 13 og 14, fra databehandleraftalen i art. 28 eller fra kravet om behandlingsgrundlag i art. 6. Det vender vi tilbage til.
Er pseudonymiserede oplysninger personoplysninger?
Det er det spørgsmål, der har fyldt mest siden 2025, og svaret er blevet mere nuanceret end det, mange gamle artikler skriver. Der er tre kilder, I skal kende.
EDPB's retningslinjer 01/2025
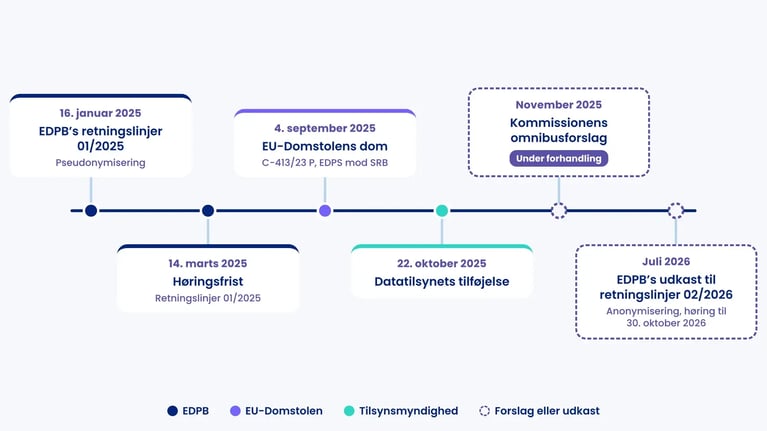
EDPB vedtog retningslinjer 01/2025 om pseudonymisering den 16. januar 2025 og sendte dem i offentlig høring frem til 14. marts 2025. En endelig version var endnu ikke offentliggjort, da denne artikel blev skrevet i september 2026, så udkastet er fortsat det mest autoritative europæiske dokument om emnet.
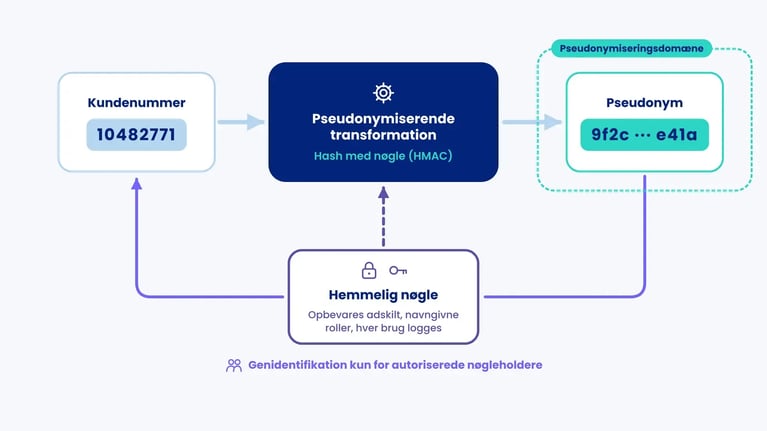
Udgangspunktet i retningslinjerne er klart: pseudonymiserede oplysninger, der kan henføres til en person ved brug af supplerende oplysninger, er personoplysninger, og det gælder, selv om nøglen ligger hos en anden end den, der behandler pseudonymerne. Retningslinjerne indfører samtidig tre begreber, I med fordel kan bruge i jeres egen dokumentation: pseudonymiseringsdomænet (den kreds af personer og systemer, hvor pseudonymerne ikke må kunne kobles til personer), den pseudonymiserende transformation (selve teknikken) og pseudonymiseringshemmelighederne (nøgler og opslagstabeller). Bilaget indeholder ti gennemarbejdede eksempler fra intern analyse over forskning til tredjelandsoverførsler.
EU-Domstolens dom i sag C-413/23 P
Den 4. september 2025 afsagde EU-Domstolen dom i sag C-413/23 P, EDPS mod SRB. Sagen handlede om Den Fælles Afviklingsinstans (SRB), der havde sendt 1.104 pseudonymiserede kommentarer fra aktionærer og kreditorer i Banco Popular til Deloitte uden at oplyse de berørte om videregivelsen. Sagen blev afgjort efter forordning 2018/1725, som gælder for EU-institutioner, men definitionerne er identiske med GDPR's.
Domstolen slog tre ting fast. Personlige holdninger i en kommentar er personoplysninger om den, der har skrevet dem. Pseudonymiserede oplysninger skal ikke i alle tilfælde og for alle personer betragtes som personoplysninger, fordi pseudonymisering efter omstændighederne kan forhindre andre end den dataansvarlige i at identificere den registrerede (præmis 86). Og den dataansvarliges oplysningspligt skal vurderes på indsamlingstidspunktet og ud fra den dataansvarliges eget perspektiv, uanset hvad modtageren senere kan eller ikke kan (præmis 112 til 115). SRB skulle altså have oplyst om Deloitte som modtager, selv om Deloitte muligvis ikke kunne genidentificere nogen.
Dommen er ikke et frikort. Kan det ikke udelukkes, at modtageren har rimelige midler til at koble pseudonymerne til personer, for eksempel ved at krydstjekke med egne data, er oplysningerne personoplysninger for modtageren (præmis 85). Fordi oplysningspligten ikke afhang af Deloittes muligheder, afgjorde Domstolen selv det spørgsmål og stadfæstede EDPS' afgørelse over for SRB. Kun et særskilt anbringende om SRB's ret til god forvaltning blev sendt tilbage til Retten.
Datatilsynets to præciseringer
Datatilsynet reagerede samme dag og igen den 22. oktober 2025 efter et stort antal henvendelser. Tilføjelsen fra oktober handler om databehandlere og er den, flest danske virksomheder skal forholde sig til.
Tilsynets opfattelse er, at oplysninger, som den dataansvarlige har pseudonymiseret, forbliver personoplysninger, så længe en databehandler behandler dem på den dataansvarliges vegne og efter instruks. Vurderingen skal foretages fra den dataansvarliges perspektiv, fordi det er den dataansvarlige, der har nøglen og råder over formål og midler. Databehandlerens egen mulighed for at genidentificere er ikke relevant i den konstruktion. Konsekvensen er, at I fortsat skal indgå en databehandleraftale efter art. 28, selv om databehandleren kun modtager pseudonymer. Vil databehandleren bruge oplysningerne til egne formål, er det en videregivelse, der kræver hjemmel hos jer.
Datatilsynets vejledningsside om personoplysninger er siden opdateret og skriver nu, at pseudonymiserede oplysninger "som udgangspunkt, men ikke altid" anses for personoplysninger, og at vurderingen skal tage udgangspunkt i behandlingens kontekst og den behandlendes muligheder for identifikation.
Hvad betyder det i praksis?
For jer som dataansvarlig ændrer dommen ikke meget: I har nøglen, oplysningerne er personoplysninger, og alle forpligtelser gælder. Dommen får betydning i to situationer. Den ene er, når I modtager pseudonymiserede data fra en anden dataansvarlig uden nøgle, uden ret til at få den og uden andre data at krydstjekke med. Der kan I efter en dokumenteret vurdering nå frem til, at oplysningerne ikke er personoplysninger for jer. Den anden er, når I videregiver, hvor dommen understreger, at oplysningspligten over for de registrerede gælder uanset modtagerens evner.
Kommissionens forslag til en digital omnibus fra november 2025 ville skrive den relative tilgang direkte ind i art. 4, nr. 1. Forslaget mødte kritik fra EDPB og EDPS i deres fælles udtalelse fra februar 2026, og Rådets kompromistekster har siden ændret og flyttet formuleringen. Forhandlingerne om GDPR-delen var ikke afsluttet, da denne artikel blev skrevet, så byg ikke jeres vurderinger på omnibussen endnu.
Pseudonymisering vs anonymisering
Forskellen er juridisk afgørende, fordi anonyme oplysninger falder uden for GDPR, mens pseudonymiserede oplysninger som hovedregel ikke gør. Den er også praktisk afgørende, fordi anonymisering er langt sværere at lykkes med, end de fleste tror.
| Aspekt | Pseudonymisering | Anonymisering |
|---|---|---|
| Kan vendes om? | Ja, af den der har nøglen | Nej, skal være uigenkaldelig |
| Gælder GDPR? | Ja for nøgleholderen, og som hovedregel for databehandlere | Nej, hvis anonymiseringen holder |
| Selve processen | Er en behandling, der er dækket af det oprindelige behandlingsgrundlag | Er en behandling, der kræver behandlingsgrundlag |
| Sammenkobling på personniveau | Mulig via pseudonymet, det er ofte hele pointen | Skal være forhindret, også over tid og på tværs af datasæt |
| Nytteværdi af data | Høj, detaljerne bevares | Lavere, fordi detaljer skal generaliseres eller fjernes |
| Typiske anvendelser | Analyse, test, forskning med opfølgning, deling med leverandører | Offentliggjort statistik, open data, træningsdata uden opfølgning |
| Europæisk vejledning | EDPB 01/2025 (udkast, januar 2025) | EDPB 02/2026 (udkast, juli 2026, høring til 30. oktober 2026) |
Et datasæt, hvor navne er fjernet, men hvor fødselsdato, postnummer og køn står tilbage, er ikke anonymt. Det er højst pseudonymiseret, og ofte ikke engang det, hvis der ikke er nogen beskyttet nøgle. Den klassiske fejl i danske spørgeskemaundersøgelser og HR-analyser er at love anonymitet, hvor der reelt kun er tale om pseudonymisering. Datatilsynet gør i sit katalog over foranstaltninger opmærksom på, at begge processer er vanskelige og kræver forståelse for, hvordan individer kan identificeres i et datasæt.
Teknikker til pseudonymisering
Valget af teknik afgør, hvor robust jeres pseudonymisering er over for angreb, og hvor brugbar den er i drift. ENISA's rapport Pseudonymisation techniques and best practices fra 2019 og EDPB's retningslinjer beskriver de samme grundteknikker. Her er de vigtigste, sat over for hinanden.
| Teknik | Sådan virker den | Hemmelighed der skal beskyttes | Styrker og svagheder |
|---|---|---|---|
| Tæller | Hver person får et løbenummer (1, 2, 3 ...) | Opslagstabellen | Enkel. Rækkefølgen kan afsløre indsamlingstidspunkt. Kun til små, lukkede datasæt. |
| Tilfældigt tal | Hver person får et tilfældigt genereret pseudonym | Opslagstabellen | Ingen sammenhæng mellem pseudonym og person. Kræver, at tabellen med alle koblinger opbevares sikkert. |
| Hash uden nøgle | Identifikatoren køres gennem en envejsfunktion (fx SHA-256) | Ingen, og det er problemet | Sårbar over for brute force og ordbogsangreb. Alle gyldige CPR-numre eller e-mailadresser kan hashes og sammenlignes. ENISA fraråder den til identifikatorer med lille værdirum. |
| Hash med nøgle (HMAC) | Envejsfunktion kombineret med en hemmelig nøgle | Nøglen | Robust, hvis nøglen beskyttes. Deterministisk, så samme person får samme pseudonym på tværs af datasæt, hvilket muliggør sammenkobling. EDPB anbefaler envejsfunktioner frem for kryptering, hvor tilbageførsel ikke er nødvendig. |
| Kryptering | Identifikatoren krypteres med en symmetrisk eller asymmetrisk nøgle | Nøglen | Kan vendes om direkte uden opslagstabel. Kræver nøglestyring og er afhængig af algoritmens holdbarhed over tid. |
| Tokenisering | Værdien erstattes med et token, der bevarer formatet, koblingen ligger i en tokenhvælving | Tokenhvælvingen | Udbredt til betalingskort og testdata. Hvælvingen bliver et højværdimål og skal sikres som sådan. |
Ud over teknikken skal I vælge en politik. Deterministisk pseudonymisering giver samme person samme pseudonym hver gang, hvilket er nødvendigt, hvis I skal følge personer over tid, men også gør det lettere at sammenkoble datasæt uden lov. Randomiseret pseudonymisering giver et nyt pseudonym pr. datasæt eller pr. transaktion. EDPB peger på transaktionspseudonymer som særligt velegnede til at begrænse skaden ved uautoriseret videregivelse. Vælg den svageste kobling, formålet tillader.
Sådan indfører I pseudonymisering i seks trin
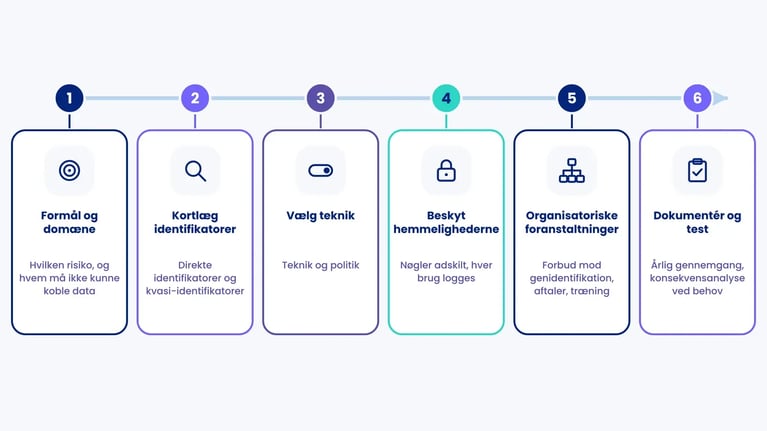
Pseudonymisering er ikke et it-projekt alene. Det er en beslutning om, hvem der må vide hvad, understøttet af teknik. Processen her følger strukturen i EDPB's retningslinjer og passer til de fleste organisationer med 50 ansatte og opefter.
Trin 1: Definér formål og pseudonymiseringsdomæne
Skriv ned, hvilken risiko pseudonymiseringen skal reducere, og hvem der ikke må kunne koble oplysningerne til personer. Er det analyseafdelingen, en ekstern leverandør, en forskergruppe eller alle uden for et kernehold i HR? Domænet afgør alt det næste. Tag udgangspunkt i den behandlingsaktivitet, oplysningerne indgår i, så dokumentationen lander i fortegnelsen.
Trin 2: Kortlæg identifikatorer og kvasi-identifikatorer
Direkte identifikatorer er nemme: navn, CPR-nummer, e-mail, telefonnummer, kundenummer. Kvasi-identifikatorer er sværere: fødselsdato, postnummer, stillingsbetegnelse, sjældne diagnoser, fritekst. Kombinationen af tre eller fire kvasi-identifikatorer peger ofte på én person i et dansk datasæt. Beslut for hver kolonne, om den skal pseudonymiseres, generaliseres (fødselsår i stedet for fødselsdato) eller udelades.
Trin 3: Vælg teknik og politik
Brug tabellen ovenfor. Skal I kunne føre pseudonymet tilbage, så vælg kryptering eller opslagstabel. Skal I kun kunne sammenkoble uden at føre tilbage, så vælg hash med nøgle. Skal I hverken sammenkoble eller føre tilbage, så overvej, om anonymisering er det rigtige, eller brug randomiserede pseudonymer. Undgå hash uden nøgle til CPR-numre, e-mailadresser og andre identifikatorer, der kan gættes.
Trin 4: Beskyt hemmelighederne
Nøgler og opslagstabeller skal ligge i et andet system end pseudonymerne, med adgang for navngivne roller, logning af hver anvendelse og en fast procedure for nøgleskift. Overvej et nøglestyringssystem eller en betroet tredjepart som nøgleholder, hvis I deler data med flere. Skriv proceduren for tilbageførsel ned: hvem må bede om det, hvem godkender, og hvordan logges det.
Trin 5: Læg organisatoriske foranstaltninger omkring
Teknik holder kun, hvis organisationen holder. Det betyder skriftligt forbud mod genidentifikationsforsøg for alle i domænet, kontraktklausuler over for leverandører og forskningspartnere, awareness-træning af de medarbejdere, der arbejder med pseudonymerne, og en risikovurdering, der dokumenterer, hvorfor risikoen for genidentifikation i domænet er ubetydelig. Husk, at pseudonymisering hos en databehandler stadig kræver databehandleraftale.
Trin 6: Dokumentér, test og gentag
Dokumentér valg af teknik, domæne, nøgleholdere og risikovurdering, så I kan påvise det efter art. 5, stk. 2. Test genidentifikationsrisikoen med de data, domænet faktisk har adgang til, ikke med et idealiseret datasæt. Sæt en årlig gennemgang i årshjulet, fordi både datasæt, teknologi og trusler ændrer sig. Er det et nyt system eller en ny behandling med høj risiko, hører pseudonymiseringen med i jeres konsekvensanalyse efter art. 35.
Et regneeksempel: pseudonymisering af kundedata til ekstern analyse
Kystdata ApS, analysebureauet Fjordindsigt og Mette Kjær er fiktive. Vi har opfundet dem til denne artikel, og de er hverken kunder eller en case.
Kystdata er en dansk webshop med 120 ansatte og 85.000 aktive kunder. Mette Kjær er compliance-ansvarlig og har fået en henvendelse fra marketing: de vil have et eksternt bureau, Fjordindsigt, til at analysere købsmønstre over tre år og bygge segmenter. Bureauet skal ikke kontakte kunderne, kun levere segmenter tilbage til Kystdata.
Mette definerer domænet som Fjordindsigt og alle uden for Kystdatas dataplatformsteam. Hun gennemgår de 14 kolonner i udtrækket. Kundenummer, navn, e-mail og adresse er direkte identifikatorer. Fødselsdato, postnummer og seneste købsdato er kvasi-identifikatorer. Hun beslutter, at kundenummeret erstattes med et pseudonym beregnet som HMAC med en nøgle, der kun findes i Kystdatas nøglehvælving. Navn, e-mail og adresse udelades helt. Fødselsdato bliver til aldersinterval på fem år, postnummer skæres til de to første cifre, og købsdatoer afrundes til uge. Tilbage er ti kolonner, hvor ingen kombination peger på færre end 20 kunder i testkørslen.
Fjordindsigt får ingen nøgle, ingen ret til at få den og et kontraktligt forbud mod at forsøge genidentifikation eller kombinere med andre data. Segmenterne kommer tilbage med pseudonymer, som Kystdatas dataplatformsteam oversætter til kundenumre med nøglen. To personer har adgang til nøglen, og hver oversættelse logges.
Så kommer den juridiske vurdering. For Kystdata er datasættet personoplysninger, fordi de har nøglen. Fjordindsigt behandler på Kystdatas vegne og efter instruks, så efter Datatilsynets præcisering fra oktober 2025 er oplysningerne også personoplysninger i den konstruktion, og Mette indgår en databehandleraftale. Analysen er et nyt formål i forhold til ordrebehandlingen, så hun laver en forenelighedsvurdering efter art. 6, stk. 4, hvor pseudonymiseringen og dataminimeringen trækker i retning af forenelighed. Hun opdaterer privatlivspolitikken, så bureauet fremgår som modtagerkategori, fordi oplysningspligten gælder uanset bureauets evne til at genidentificere.
Regnestykket i sikkerhedsvurderingen ser sådan ud. Uden pseudonymisering ville et læk hos bureauet ramme 85.000 kunder med navn, e-mail og komplet købshistorik, et brud med sandsynlig underretningspligt efter art. 34 og risiko for phishing rettet mod kunderne. Med pseudonymisering og minimering indeholder et læk aldersintervaller, to postnummercifre og ugebaserede købsmønstre uden nøgle. Mette vurderer, at bruddet stadig skal anmeldes til Datatilsynet inden 72 timer efter art. 33, fordi det er personoplysninger for Kystdata, men at underretning af kunderne efter art. 34, stk. 3, litra a, kan undlades, hvis vurderingen viser, at oplysningerne reelt er uforståelige for den, der har fået fat i dem. Hun skriver begrundelsen ned på forhånd, så den ligger klar, hvis bruddet sker.
Havde bureauet selv skullet vælge kunder ud til en kampagne, ville pseudonymiseringen ikke have givet mening, fordi koblingen så skulle ligge hos bureauet. Pointen med eksemplet er, at pseudonymisering virker bedst, når I først har besluttet, hvem der ikke behøver at vide, hvem kunderne er.
Hvad pseudonymisering ikke løser
Pseudonymisering er et godt værktøj, og det bliver bedre af at kende dets grænser. Her er dem, vi oftest ser overset.
Den fjerner ikke GDPR. For den dataansvarlige med nøglen gælder alle forpligtelser: behandlingsgrundlag, fortegnelse, oplysningspligt, de registreredes rettigheder, databehandleraftaler og anmeldelse af brud. Den er et lag oven på compliance, ikke en erstatning.
Den beskytter ikke mod sammenkoblingsangreb i sig selv. Et pseudonymiseret datasæt med præcise tidsstempler, geodata eller sjældne attributter kan ofte kobles til personer via andre datasæt. Datatilsynets afgørelse fra 18. juni 2020 om uddrag af gymnasieopgaver (j.nr. 2019-431-0045) viser, at selv tekstuddrag uden navne blev anset for pseudonymiserede personoplysninger, fordi de afspejlede elevens tankegang og kunne kobles til den fulde opgave i et andet system. Databehandleren fik alvorlig kritik for at videregive dem til forskere uden instruks.
Den er ikke stærkere end nøglestyringen. Ligger nøglen i samme database som pseudonymerne, eller har alle udviklere adgang, er kravet i art. 4, nr. 5, om separat opbevaring ikke opfyldt.
Den er ikke anonymisering. Skal data offentliggøres eller deles bredt uden GDPR-forpligtelser, er det anonymisering, I skal vurdere, og den kræver et andet og strengere arbejde. EDPB's udkast til retningslinjer 02/2026 om anonymisering, i høring til 30. oktober 2026, er det sted, I skal starte.
Og den er ikke gratis. Pseudonymisering koster nytteværdi, udviklingstid og drift af nøglehvælvinger. GDPR kræver passende foranstaltninger efter art. 32, ikke pseudonymisering af alt. En risikovurdering, der konkluderer, at kryptering og adgangsstyring er tilstrækkeligt for en given behandling, er en fuldt legitim konklusion, så længe den er begrundet og dokumenteret. Vores artikel om informationssikkerheds-risikostyring viser, hvordan én metode kan dække flere forpligtelser.
Sådan understøtter .legal jeres arbejde med pseudonymisering
Pseudonymisering skal dokumenteres tre steder: på behandlingsaktiviteten, i risikovurderingen og i aftalerne med dem, der modtager data. I .legal compliance platform hænger de tre sammen. I GDPR-modulet registrerer I pseudonymisering som en teknisk foranstaltning direkte på den behandlingsaktivitet, den beskytter, så fortegnelsen efter art. 30 viser både oplysningskategorier, modtagere og de foranstaltninger, der gælder. Data mapping giver overblik over, hvilke systemer der holder nøgler, og hvilke der kun ser pseudonymer.
I risikovurderingsmodulet dokumenterer I vurderingen af genidentifikationsrisiko og den konsekvensanalyse, som en ny analysebehandling kan kræve. Databehandleraftaler og forbuddet mod genidentifikation hos leverandører ligger i leverandørstyringen, og den årlige gennemgang af nøgler og domæne lægger I som tilbagevendende opgave i compliance-årshjulet. Platformen pseudonymiserer ikke jeres data for jer. Den sikrer, at beslutningerne om at gøre det kan findes, begrundes og påvises, når Datatilsynet eller en kunde spørger.
Book en demo, hvis I vil se, hvordan foranstaltninger, risici og leverandøraftaler kobles på samme behandlingsaktivitet.

.legal compliance platform
Administrer pseudonymisering med .legal
-
Dokumenter pseudonymiseringsprocedurer og -politikker
-
Spor databeskyttelsesforanstaltninger
-
Kortlæg personoplysninger og behandlingsaktiviteter
-
Generer compliance-rapporter